Blogg
Här finns tekniska artiklar, presentationer och nyheter om arkitektur och systemutveckling. Håll dig uppdaterad, följ oss på LinkedIn
Här finns tekniska artiklar, presentationer och nyheter om arkitektur och systemutveckling. Håll dig uppdaterad, följ oss på LinkedIn

Hur får man en språkmodell att granska ett dokument mot en checklista på ett sätt som går att lita på, felsöka och mäta? Och hur gör man det utan att skicka dokumenten till ett moln-API? I ett av våra uppdrag har vi byggt en AI-granskning i Kotlin med JetBrains agentramverk Koog. Kontrollen är uppdelad i agenter, förgreningarna ligger i grafer av noder och kanter, och modellen körs on-prem via Ollama.
Forskare som samlar in prover till en studie måste informera deltagarna skriftligt, i en så kallad forskningspersonsinformation. Texten granskas mot en checklista: framgår det att deltagandet är frivilligt, hur man återtar sitt samtycke, vart proverna skickas och så vidare. Vår tjänst låter forskaren ladda upp sitt utkast som PDF och få tillbaka ett svar med motivering per punkt, strömmat över en WebSocket medan modellen arbetar.
Domänen är specifik men problemet är generellt: ett dokument in, ett antal bedömningar ut.
Den “naiva” lösningen är att skicka hela dokumentet och hela checklistan i en prompt och be om ett JSON-svar. Problemet är att frågorna hänger ihop. Om proverna inte sparas i en biobank är frågorna om destruktion och kodnycklar inte tillämpliga. Sådana regler hamnar då i prompten, och man får hoppas att modellen följer dem. När ett svar blir fel är det dessutom svårt att se vilket steg som gick snett.
Vi delade i stället upp kontrollen i agenter som äger var sin del av checklistan, och lät flödet mellan stegen uttryckas i kod.
Koog är JetBrains ramverk för AI-agenter i Kotlin, och det är öppen källkod. En agent drivs av en strategi, alltså en riktad graf där varje nod är ett steg: ett LLM-anrop eller vanlig Kotlin-kod. Kanterna bestämmer vad som händer härnäst och kan ha villkor. Förgreningar i flödet ligger alltså i grafen och inte i prompten. Alla agenter behöver inte vara grafer: de oberoende ja/nej-frågorna är ett enda strukturerat anrop. Graferna kommer in där flödet grenar sig.
Ett exempel är kontrollen av prover som skickas utomlands. Texten ska ange vilka länder det gäller, “skickas utomlands” räcker inte. Om alla länder ligger inom EU/EES räcker det att skriva just “EU/EES”. Agenten ser ut så här:
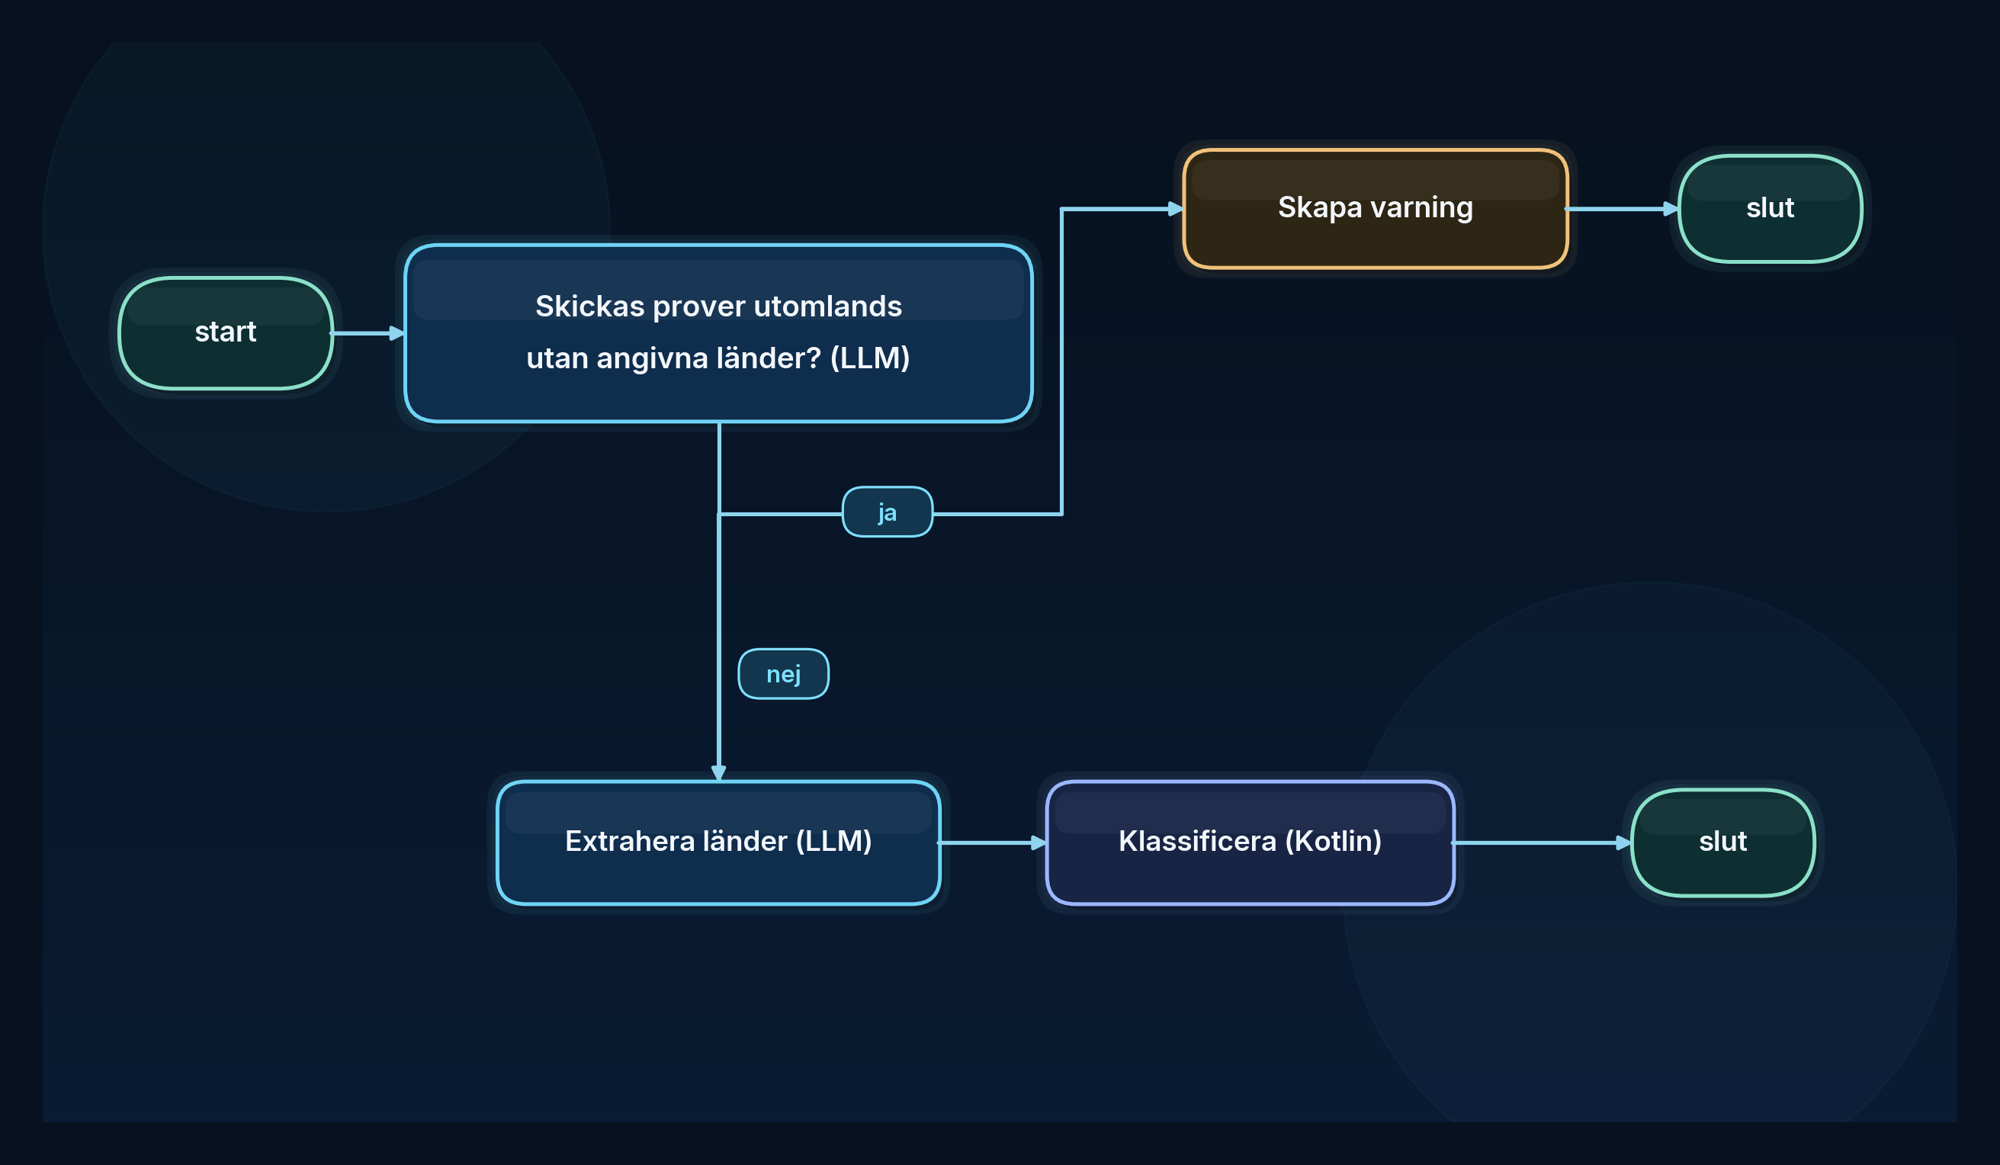
I kod, något förenklat:
private val strategy = strategy<CheckInput, ServerResponse>("eu-ees-check") {
    val detectUnspecifiedAbroad by node<CheckInput, AbroadDetection> { input ->
        AbroadDetection(input, detectUnspecifiedForeignSending(input.text))
    }
    val createAbroadWarning by node<AbroadDetection, ServerResponse> {
        InconclusiveResultMessage(questionId, "Ange vilka länder proverna skickas till.")
    }
    val extractCountries by node<AbroadDetection, CountryExtraction> { detection ->
        CountryExtraction(detection.input, extractCountryList(detection.input.text))
    }
    val classify by node<CountryExtraction, ServerResponse> { extraction ->
        classifyCountryResult(extraction.countries)
    }

    edge(nodeStart forwardTo detectUnspecifiedAbroad)
    edge(detectUnspecifiedAbroad forwardTo createAbroadWarning onCondition { it.unspecified })
    edge(detectUnspecifiedAbroad forwardTo extractCountries onCondition { !it.unspecified })
    edge(createAbroadWarning forwardTo nodeFinish)
    edge(extractCountries forwardTo classify)
    edge(classify forwardTo nodeFinish)
}

suspend fun evaluate(text: String): ServerResponse =
    AIAgent(promptExecutor = executor, llmModel = llmModel, strategy = strategy).run(CheckInput(text))
Två saker är värda att notera. Varje nod har typad in- och utdata, så kompilatorn kontrollerar att grafen hänger ihop. Och det sista steget, att avgöra om ett land ligger inom EU/EES, går inte alls till modellen. Det är en uppslagning i en lista. Modellen är bra på att hitta vilka länder en fritext nämner, men den behövs inte för att veta om Österrike är medlem i EU, och där skulle den bara vara mindre pålitlig än koden. Den delen kan enhetstestas som vilken kod som helst. Utfallen är också kod: en lista med bara EU/EES-länder ger en rekommendation att skriva just “EU/EES”, medan tredjeland och enbart Sverige går igenom utan anmärkning.
Provfrågorna visar en annan fördel med grafer. En första nod frågar modellen om proverna bevaras i en biobank. En villkorad kant leder sedan antingen vidare till frågorna om destruktion och tidsramar, eller till en nod som markerar dem som “ej tillämpligt” utan att fråga modellen alls. Samma mönster används för kodade prover och kodnyckeln, och hela kontrollen inleds med en grind som avgör om dokumentet över huvud taget är rätt sorts dokument.
Det sparar anrop, men framför allt blir resultatet konsekvent. Modellen kan inte svara att kodnyckeln förvaras säkert för prover som inte kodas.
Inget LLM-anrop returnerar fritext. Svaret är alltid en Kotlin-klass. Koogs executeStructured bygger ett JSON-schema från serializern och parsar svaret tillbaka:
@Serializable
data class LlmCheckResultBoolean(val result: Boolean, val explanation: String)

val answer = executor.executeStructured(
    prompt = buildPrimaryPrompt(text, check.title, check.aiQuestion),
    model = llmModel,
    serializer = serializer<LlmCheckResultBoolean>(),
).getOrThrow().data
Frågor som inte beror på varandra skickas i en batch och besvaras som en lista. Om modellen returnerar fel antal svar görs hela batchen om. Promptarna kräver dessutom ett citat ur texten för varje “ja”, vilket gör motiveringarna lätta att kontrollera för den som läser dem.
Vi vill ha full kontroll över vart dokumenten tar vägen, så modellen körs på en egen modellserver med Ollama. Modellen är OpenAIs open weight-modell gpt-oss i 120b-varianten. Koog abstraherar bort leverantören, så att byta till en molnmodell vore i princip att byta executor.
Det svåraste med LLM-baserade funktioner är att veta om en ändring gjorde saken bättre eller sämre. En prompt som ser bättre ut i diffen kan mycket väl ge sämre svar. Därför har vi ett test för utvärdering: en uppsättning riktiga dokument med facit som körs genom hela kedjan, gärna flera gånger per dokument eftersom svaren varierar. Resultatet blir en träffsäkerhet per modell, och samma körning görs om när promptarna ändras.
Med hjälp av dessa tester kunde vi välja rätt modell som passade för uppgiften. Med samma promptar och dokument hamnade gpt-oss:20b på 64 % och gpt-oss:120b på 82–95 %.
Låt koden göra det koden är bra på.
Använd modellen för att tolka fritext. Regler, uppslagningar och beroenden hör hemma i grafen och i vanlig kod.
Kontextfönstret bestäms på servern.
Att skicka ett eget värde per anrop får Ollama att ladda om modellen, vilket är dyrt när flera tjänster delar på en 120b-modell. Klienten skickar därför inget fönster alls. Det är modellservern som sätter storleken, och den måste räcka för ett helt dokument.
Sätt en tidsgräns.
En kontroll tar normalt 40–90 sekunder mot en frisk modellserver, men en modell som fastnar i ett långt resonemang kan hålla uppkopplingen hur länge som helst. Koogs Ollama-klient sätter inget tak på hur länge modellen får resonera, så en övergripande timeout med withTimeout ser till att socketen släpps.
Agentgrafer kan kännas överdrivet för något så enkelt som att ställa några frågor om ett dokument. Men med ett explicit flöde, typade noder, kod i stället för modell där det går, en lokal modell och ett sätt att mäta resultatet har vi fått något vi faktiskt kan förvalta och vidareutveckla. Koog passar dessutom bra i en Kotlin- och Ktor-stack, eftersom agenterna är vanlig Kotlin med coroutines hela vägen.